
AI TREND · 구글 Gemini 4 Argon, 공식 발표와 외부 테스트를 나란히 놓고 봤어요
3줄 요약
구글 발표 18개 테스트 중 12개에서 단독 1등. 실무 코딩(DeepSWE)·법률·금융 업무에서 클로드와 GPT를 앞섰다고 발표했어요.
외부 테스트 독립 평가 기관 Artificial Analysis 기준으로는 GPT-6 Astra와 공동 2등, Claude Opus 5.5보다 5점 낮아요.
진짜 무기 같은 일을 클로드의 약 1/3 비용으로 해요. 다만 지금은 일반 사용자가 쓸 수 없어요.
안녕하세요, 칼퇴하는 예린입니다. 9월 30일, 구글이 새 최상위 모델 Gemini 4 Argon을 발표했어요. 피드에는 “클로드·GPT 동시 추월”이라는 소식이 쏟아졌죠.
그런데 재밌는 건, 바로 이틀 전까지만 해도 구글이 AI 커뮤니티에서 놀림거리였다는 거예요. 그래서 오늘은 구글이 직접 발표한 숫자와 외부 기관이 같은 기준으로 잰 숫자를 나란히 놓고, 정말 역전했는지 확인해 볼게요.
① 이틀 전 ‘구글 전용 랭크’ 사건 → ② Gemini 4 Argon은 어떤 모델인지 → ③ 구글 공식 벤치마크 → ④ 독립 기관 테스트 결과 → ⑤ 가격과 정확도 → ⑥ 언제 쓸 수 있는지 → ⑦ 그래서 역전일까
1. 발표 이틀 전, ‘구글 전용 랭크’
9월 26일, 한 X 사용자가 AI 모델 티어표를 올렸어요. SSS부터 E까지 등급을 나눴는데, 맨 아래에 구글 모델만 모아 둔 ‘Google’ 칸이 따로 있었어요. E 등급보다도 아래였죠.
여기에 9월 28일, 일론 머스크가 한 줄을 달았어요. “Accurate (for now)”, 우리말로 “정확함 (지금은)”. 이 트윗은 800만 번 넘게 조회됐어요.
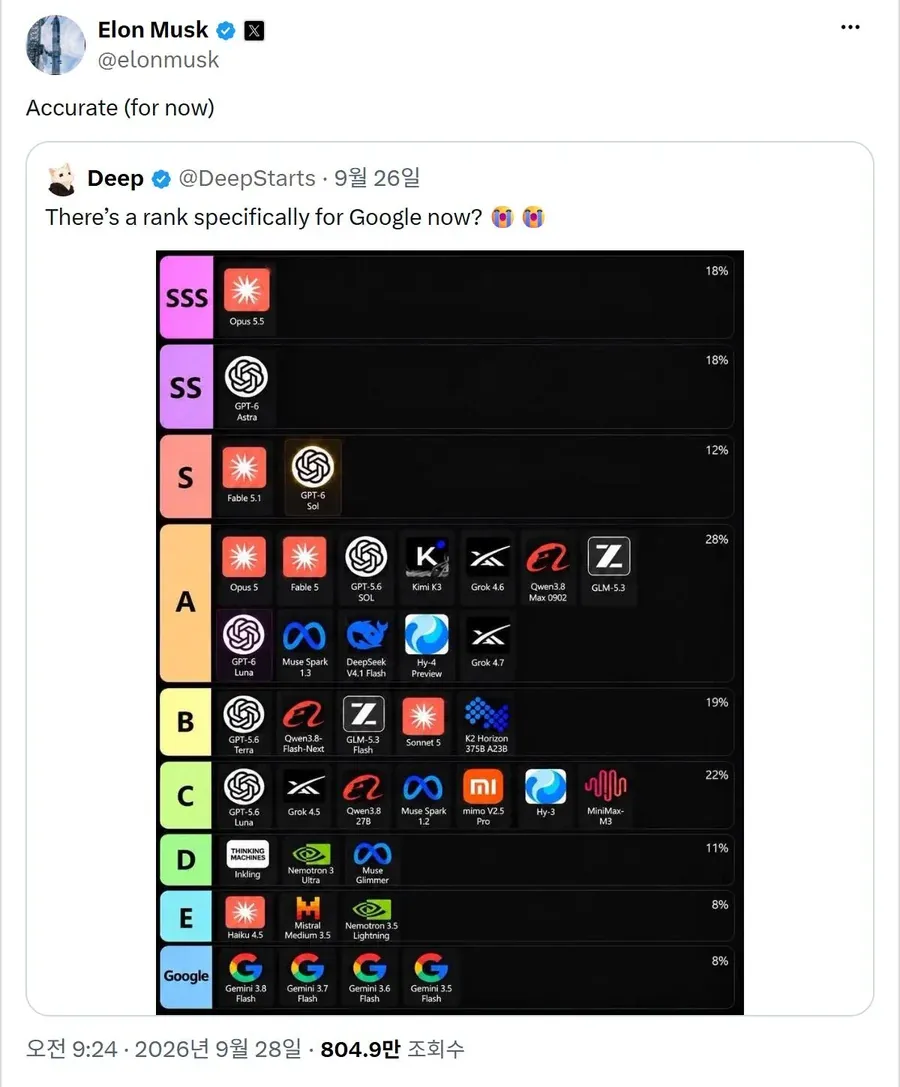
이렇게까지 놀림을 받은 데는 이유가 있어요. 구글은 예고했던 Gemini 3.5를 결국 내지 않고 건너뛰었고, 7개월 넘게 최상위 모델을 내놓지 못했거든요. 그 사이 클로드와 GPT는 계속 새 모델을 냈고요.
그리고 이틀 뒤, 머스크의 “(지금은)”이 복선이 되는 발표가 나왔어요.
2. Gemini 4 Argon은 어떤 모델이에요?
구글 공식 블로그에 따르면 Gemini 4 Argon은 복잡하고 긴 업무에 맞춘 모델이에요. 특히 세 분야를 강조했어요.
| 분야 | 구글이 말한 내용 |
|---|---|
| 실무 코딩 | 여러 단계에 걸친 실제 소프트웨어 작업 |
| 회사 업무 | 법률·금융처럼 전문 지식이 필요한 업무 |
| 보안 | 소프트웨어 취약점을 찾고, 확인하고, 고치는 작업 |
눈에 띄는 숫자도 하나 있어요. 한 번에 만들어 낼 수 있는 답변 길이(출력 토큰)가 6만 4천 → 100만 토큰으로 크게 늘었어요. 긴 보고서나 큰 코드 작업을 한 번에 맡길 수 있다는 뜻이에요.
3. 구글 공식 발표: 18개 중 12개 1등
구글은 자사 모델과 경쟁 모델을 같은 표에 놓고 비교했어요. 파란 칸이 Argon이 1등인 테스트예요.

18개 테스트 중 Argon이 단독 1등 12개, GPT-6 Astra가 3개, Claude Opus 5.5가 2개를 가져갔어요. 대표적인 것만 추리면 이래요.
| 테스트 | Argon | Opus 5.5 | GPT-6 Astra |
|---|---|---|---|
| 실무 코딩 (DeepSWE) | 77.9% | 74.2% | 74.1% |
| 법률·금융 등 업무 (Vals Index) | 68.9% | 67.0% | 63.1% |
| 아주 긴 문서 이해 (GraphWalks 1M) | 84.2% | 66.8% | 71.8% |
| 터미널 코딩 (Terminal-bench 4.0) | 57.4% | 66.4% | 58.2% |
| 컴퓨터 조작 (OSWorld-2.0) | 69.2% | – | 72.6% |
4. 외부 테스트: 공동 2등
Artificial Analysis는 AI 모델을 회사와 상관없이 같은 시험지로 직접 채점하는 독립 평가 사이트예요. 지능·속도·비용을 나란히 보여줘서, 새 모델이 나오면 “실제로는 몇 등인지” 확인할 때 업계에서 가장 많이 인용돼요.

이 기준으로 보면 결과가 달라져요.
| 항목 | Argon | Opus 5.5 | GPT-6 Astra |
|---|---|---|---|
| 종합 지능 점수 | 52.6 | 57.6 | 52.7 |
| 실무 작업 (GDPval-AA) | 1,611 | 1,846 | 1,542 |
| 어려운 추론 (Humanity’s Last Exam) | 57.1% | 61.4% | 54.7% |
| 과학 코딩 (SciCode) | 61.8% | 66.9% | 56.5% |
| 터미널 코딩 (Terminal-Bench 4.0) | 57.1% | 59.6% | 59.1% |
종합 점수는 GPT-6 Astra와 사실상 같고, Claude Opus 5.5보다는 5점 낮아요. 구글 발표만 보면 1등이지만, 같은 기준으로 재면 공동 2등인 셈이에요.
그래도 구글 입장에선 의미 있는 결과예요. 이전 모델 Gemini 3.1 Pro보다 종합 점수가 23점이나 올라서, Artificial Analysis도 “구글이 다시 상위 3개 연구소로 돌아왔다”고 평가했어요.
5. 대신 무기는 가격과 정확도
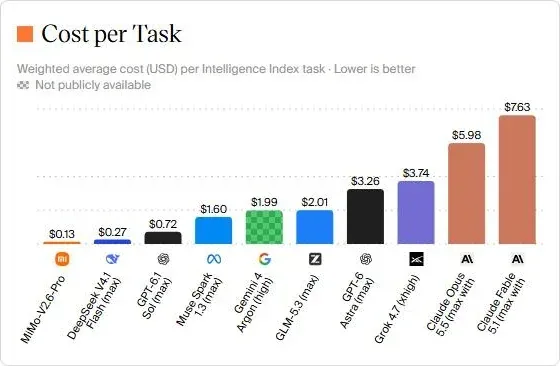
성능은 2등이지만, 가격을 보면 이야기가 달라져요. 같은 테스트 묶음을 처리하는 데 든 비용이에요.
| 모델 | 과제 1개당 비용 |
|---|---|
| Gemini 4 Argon | $1.99 |
| GPT-6 Astra | $3.26 |
| Claude Opus 5.5 | $5.98 |
클로드의 약 1/3 비용이에요. API 가격도 출시 기념으로 입력 100만 토큰당 $2, 출력 $10로 잡았어요. (기념 기간이 끝나면 $4 / $20로 올라가요.)
없는 말을 지어내는 비율(환각)도 낮은 편이에요. The Decoder 보도에 따르면 Argon은 15%, GPT-6 Astra는 51%였어요.
6. 그래서 언제 쓸 수 있어요?
여기가 함정이에요. 지금은 일반 사용자가 쓸 수 없어요. 구글은 단계적으로 열겠다고 했어요.
| 순서 | 누가 쓸 수 있나 |
|---|---|
| 지금 | 보안 전문가(Fairwind 프로그램) · 미국 정부 기관 |
| 다음 | 유료 API 고객 · Google AI Ultra 구독자 |
| 그 다음 | 일반 개발자 · 일반 사용자 |
공개 날짜는 아직 없고, “최대한 빨리”라고만 했어요.
7. 그래서, 역전일까?
| 항목 | 결과 |
|---|---|
| 성능 | 추격 성공, 아직 2등 |
| 가격 | 역전 |
| 정확도 | 환각 적음, 강점 |
| 사용 | 아직 못 씀 |
제 한 줄 평은 이거예요. “구글 전용 랭크는 졸업, 1등까진 아직.”
지금 클로드나 GPT를 잘 쓰고 있다면 굳이 바꿀 필요는 없어요. 다만 일반 사용자에게 풀리면, 긴 문서 요약이나 자료 분석처럼 양이 많은 업무는 Argon으로 한번 돌려볼 만해요. 싸고 정확한 2등은 업무용으로 꽤 매력적이거든요. 풀리면 직접 써보고 후기로 다시 올게요.
여러분은 어떻게 보세요? 머스크의 “(지금은)”, 이번엔 틀린 걸까요? 댓글로 알려주세요.
참고한 자료
Google 공식 블로그: Gemini 4 Argon · Artificial Analysis · 일론 머스크 트윗 · The Decoder · Trending Topics
벤치마크 점수와 가격은 2026년 10월 1일 기준이에요. 모델이 공개되거나 측정이 갱신되면 바뀔 수 있으니, 결제나 도입 전에는 공식 페이지를 꼭 확인해 주세요.